面向安全运营中心 (SOC) 自动化的 AI 技术
早在 21 世纪初,我们就开始应用机器学习算法检测恶意软件。此后,攻击者不断改进攻击手段。如今,定向攻击具有高度隐蔽性,其中一个特点是尽量减少使用可被反病毒软件检测到的恶意软件。相反,许多攻击者会利用社会工程手段获取初始访问权限,随后利用系统配置错误和合法软件,在遭到入侵的基础设施中进行横向移动并维持持久访问。
检测此类攻击,需要收集并分析大量有关企业网络中设备、应用程序和用户行为的数据。每当检测到可疑活动,分析人员还需要进一步核实,判断其究竟是攻击行为还是正常活动。随着组织内资产数量不断增加,收集到的遥测数据也随之增多,给安全运营中心和 MDR 服务的分析师带来更大的工作负担.
基于 AI 技术的自动化能够从以下几个方面简化这项工作:
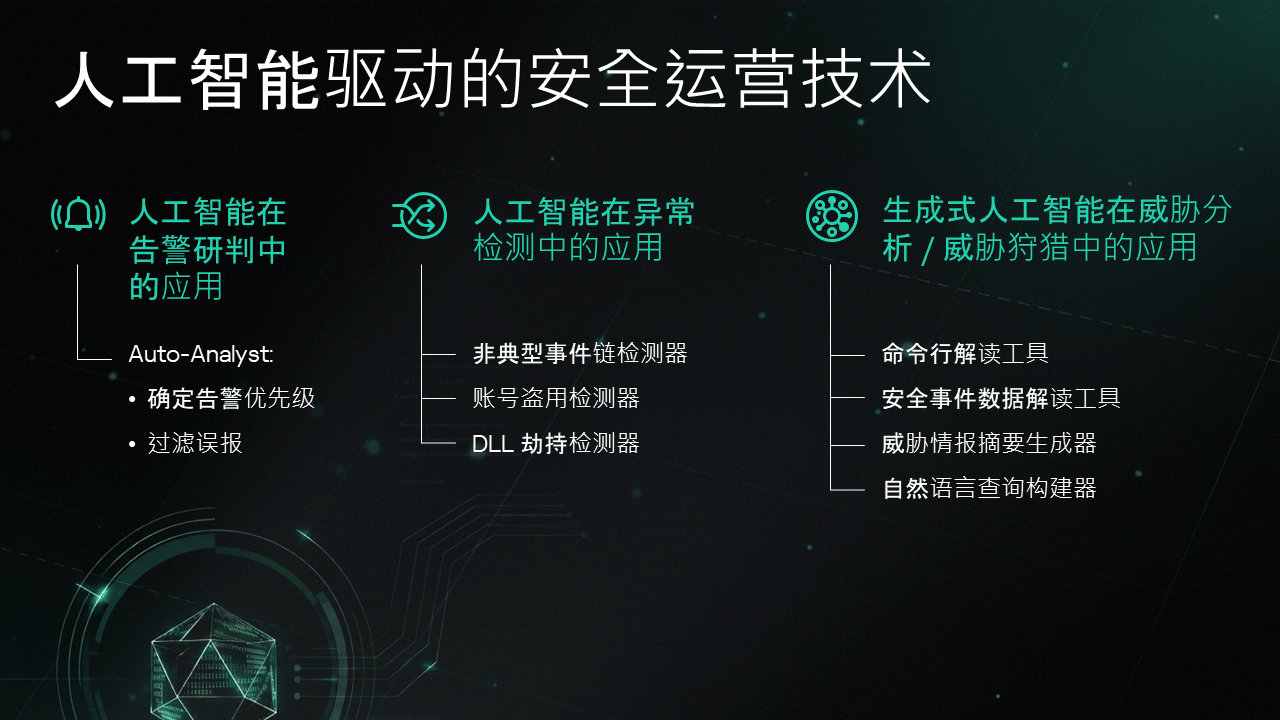
- 警报分类:对 MDR/XDR/SIEM 遥测数据中与可疑事件相关的警报进行优先级排序,并过滤误报。
- 行为异常检测: 识别账户盗用、主机入侵、DLL 劫持攻击及其他恶意活动的迹象。
- 数据呈现:汇总并解读命令行、事件及 TI 报告。
- 自然语言威胁搜索:将分析师提出的假设转化为 SQL 查询。
下面将介绍这些 AI 技术如何在我们的产品和服务中得到实际应用。
警报的自动分析与优先级排序
我们的 MDR 服务客户的基础设施每天会产生数十亿条安全事件。数据收集系统根据特定检测规则识别可疑事件,并以警报的形式向分析师报告这些潜在的恶意活动,每年产生数十万条警报。然而,其中只有约十分之一与真实安全事件有关。
为此,我们开发了名为自动分析师的 AI 系统。该系统采用监督式机器学习,使用经过 SOC 分析师判定的警报数据进行训练,旨在准确识别由合法网络活动产生的误报。
该系统基于 CatBoost 实现机器学习。CatBoost 是一种广泛应用的梯度提升库。经过训练的自动分析师会自动筛选警报,仅将真实安全事件发生概率超过指定阈值的警报提交人工审核。该阈值根据可接受的错误率设定。通过这一机制,约 30% 的警报可由 AI 自动处理,让 SOC 团队将更多精力投入复杂任务。对于需要人工分析的警报,系统也会按照优先级进行排序,帮助分析师优先处理最关键的警报。
有关自动分析师实际运行细节的更多信息,包括训练数据管理、结果抽查等,请参阅我们的专家撰写的另一篇文章。
SIEM 中的异常检测
这种方法的核心是利用系统正常运行期间收集的遥测数据训练 AI 模型,以便在系统行为偏离正常模式时发出警报。
在大型分布式系统中应用此类算法并不容易,因为模型构建过程中需要考虑的参数数量庞大。此外,这类模型还可能产生大量误报:在拥有数千名用户的组织中,许多不常见的行为实际上可能是正常活动。
不过,对于能够建立足够准确的正常运行模型的单个资产或流程,这种方法可以发挥很好的作用。
异常事件链
在这种情况下,系统利用 SIEM 关联规则的典型触发序列数据,建立正常行为模型。如果某一序列频繁触发,通常意味着这类警报属于误报,例如自动执行管理脚本所产生的警报。这些数据有助于识别基础设施中的常规活动。
我们的 AI 系统会将主机的典型行为表示为一组特定规则的触发概率,并据此评估新事件链是否符合相应基础设施中的常见行为模式。如果检测到非典型事件链,系统就会提高相关警报的优先级,提醒安全专家进一步分析。
账户盗用
另一种异常检测技术可用于识别用户账户可能存在的未授权活动。机器学习系统会利用账户与 IP 地址、账户与主机、账户与国家或地区等实体之间的关联数据,建立典型的账户行为画像。
攻击者使用被盗账户时,通常会打破账户原有的活动模式。例如,他们可能从异常 IP 地址登录系统,随后尝试在系统内横向移动或提升权限,并访问账户合法用户通常不会接触的基础设施节点。AI 系统能够识别此类异常行为,并在警报中汇总相关上下文信息,帮助分析师快速响应。
DLL 劫持
DLL 劫持是 Windows 操作系统中的一种攻击技术。攻击者会将合法进程调用的动态链接库替换为恶意库。由于恶意库会在合法进程的受信任地址空间内执行,传统安全解决方案很难识别此类攻击。从安全解决方案的角度来看,这些活动可能与受信任进程的正常行为没有明显区别。近年来,利用 DLL 劫持技术发起的攻击数量增加。
为了构建能够区分恶意库加载与合法库加载的 AI 模型,我们的专家识别了此类攻击中可能出现的一系列特征,包括库文件路径异常、可执行文件路径异常、可执行文件被重命名、库文件大小或结构发生变化,以及缺少数字签名等。模型的训练样本来自两个渠道:内部自动化处理系统提供的 DLL 加载数据,以及 KSN 收集的匿名化用户遥测数据。
有关该模型训练过程的更多信息,请参阅另一份报告。即使在试点阶段,这项技术也已帮助阻止了针对客户系统的多起攻击。
基于生成式模型的 AI 助手
前面介绍的案例都涉及将 AI 用作分类器:系统接收一个新的信息对象,由模型判断其所属类别,例如判断一张图片中是否有一只狗。这类机器学习系统通常使用与特定任务直接相关的有限数据集进行训练。
生成式 AI 的工作方式则有所不同。系统接收用户以查询形式提出的需求,例如“画一只狗”,然后生成符合要求的新内容。为此,系统需要具备相关领域的广泛知识。这些知识主要来自大语言模型在海量公开数据上进行的预训练。
因此,基于大语言模型的系统能够处理广泛的任务,包括非结构化数据处理。当前的大语言模型尤其擅长文本处理,例如翻译、改写和摘要,也就是在保留原文核心信息的基础上,将内容精简为更短的文本。
为了在安全产品和服务中实现这类文本处理任务,我们开发了自己的 AI 助手技术。该技术负责整理发送给大语言模型的查询数据、构建并发送查询、处理返回结果,再将结果传递给分析师,同时保障整个通信过程的安全。
AI 助手可以与客户根据自身任务和需求选择的任意大语言模型配合使用。例如,云端模型通常具备更强的功能,而本地部署的模型则可以避免将机密数据传输给第三方服务。
命令行解读
经过混淆处理的命令行是常见的可疑事件类型,需要分析师仔细检查。攻击者利用这类命令行直接向受攻击主机的操作系统下达指令,同时规避安全检测。为了隐藏恶意命令,他们会采用编码、语法操纵等多种混淆手段,使分析师难以判断命令的真实意图。
我们的 AI 助手首先对可疑命令行进行静态反混淆处理,随后向大语言模型发送一系列查询,解析命令行中的各项参数。最后,助手会生成一份摘要,向分析师说明该命令行的具体功能及其潜在风险。
事件数据摘要
为了实现事件响应自动化,如今的 SOC 通常会使用事件响应平台(IRP)。这类平台会将与某一事件相关的数据汇集到同一张事件卡片中,包括相关安全事件和工件。
然而,汇集的数据量可能非常庞大,人工梳理事件的所有细节往往需要耗费大量时间。此外,分析师有时还需要回顾历史事件,而这通常意味着要重新整理分散在不同位置的信息。
生成式 AI 助手能够大幅简化这一工作。它会收集与事件相关的全部遥测数据,并利用大语言模型生成简明的事件摘要,说明事件的初始攻击途径、攻击者在整个事件过程中采取的行动,以及相应的响应建议。
威胁情报摘要
调查安全事件时,分析师经常需要参考其他信息来源,以进一步了解相关威胁。其中一个重要来源就是我们的威胁情报门户(TIP)。在超过 25 年的威胁检测工作中,卡巴斯基已在该门户中积累了超过 5 PB 的威胁情报,涵盖恶意文件的哈希值、统计特征和行为特征、命令与控制中心的 IP 地址和 URL,以及黑客组织的战术、技术与程序(TTP)等信息。
使用该门户的典型流程如下:分析师上传在事件调查中发现的可疑样本,并在门户的沙盒环境中运行。随后,分析师便可获得详细的分析结果,包括恶意软件的检测结果及哈希值、恶意软件曾连接的域名,以及从互联网下载的文件等信息。
这些数据还可以作为搜索条件,用于从公开来源获取更多威胁情报。例如,门户可能会提供某个 APT 组织的相关报告,而该组织使用的 C2 地址与样本在沙盒中运行时检测到的地址一致。借助这些信息,分析师可以获取更多入侵指标(IoC),并在自身基础设施中开展排查。
然而,查阅和整理分散的威胁情报报告往往需要耗费大量时间,尤其是在报告采用不同语言和格式的情况下。我们的 AI 助手可以生成威胁情报报告的结构化摘要,说明某个指标与特定组织之间的关联、该组织曾在哪些地区开展活动及其活动时间,以及使用过哪些技术等。此外,AI 助手还可以根据开源情报(OSINT)数据,生成特定 APT 组织的结构化描述。
使用自然语言进行威胁搜索
当分析师希望进一步了解当前安全事件,或根据新获得的指标主动排查潜在威胁时,通常需要向日志存储系统或 SIEM、EDR、XDR 数据库发起查询,检索其中收集的安全事件。然而,将分析师提出的假设转化为语法准确、参数无误的 SQL 查询,往往需要耗费大量时间,从而拖慢调查和响应流程。
我们的 AI 助手支持分析师使用自然语言查询数据库,无需手动编写复杂的查询语句,只需直接描述自己的查询需求即可。例如,分析师可以输入:“显示昨天在指定主机上发生的、涉及某个特定名称的可执行文件的所有事件。”收到请求后,AI 助手会利用大语言模型从数据模型中选择所需字段,并据此生成 SQL 查询,发送至数据库执行。在实际执行之前,分析师可以查看 AI 生成的查询语句,检查其逻辑,并根据需要调整参数或语法。


